
Guía de Modelos Locales y Privacidad El Poder de los SLM
Facilitan el cumplimiento normativo. Ideal para información confidencial. Local no significa automáticamente seguro. La configuración sigue siendo esencial. Cada vez más procesadores incorporan NPUs. 🧠 MODELOS RECOMENDADOS PARA DESPLEGAR HOY Calidad cercana a modelos comerciales.
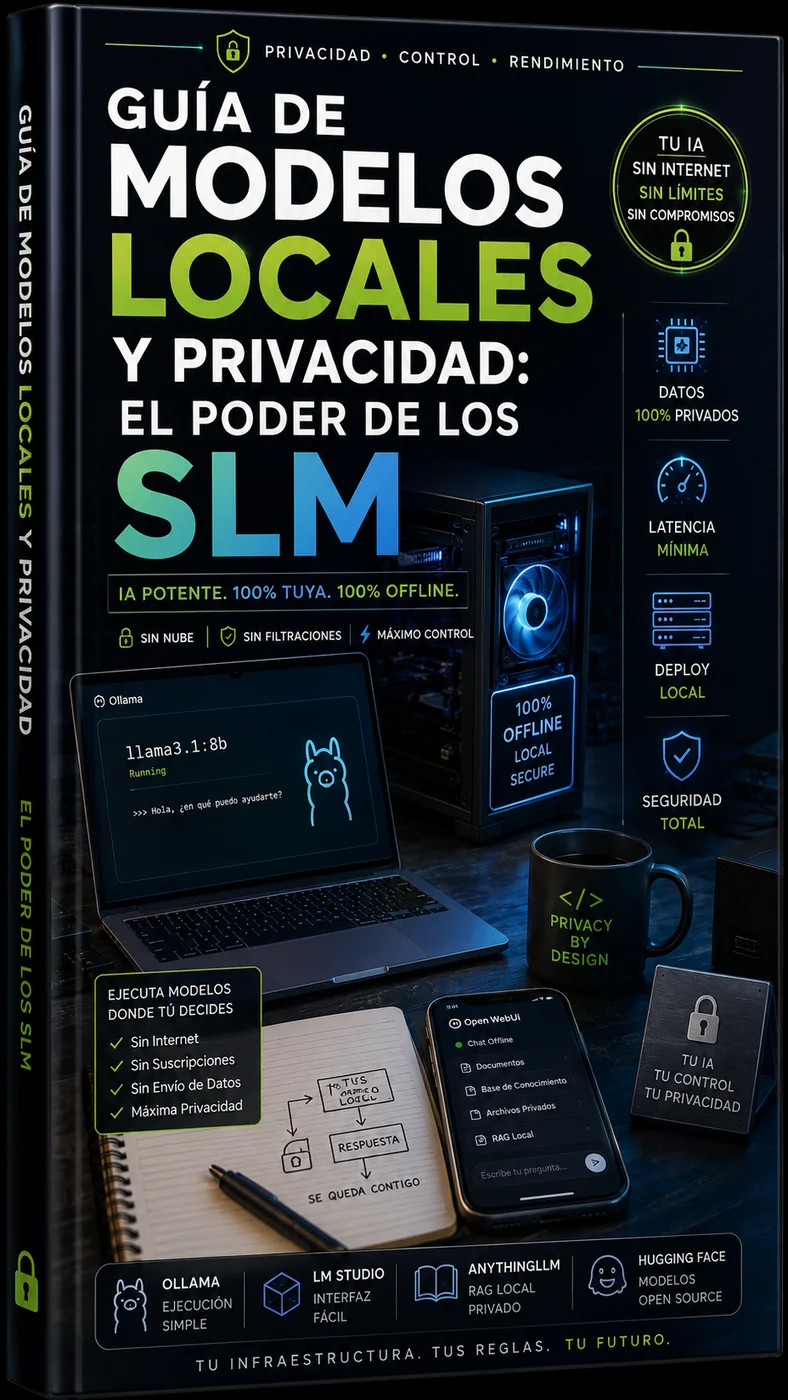
🚀 LA REVOLUCIÓN DE LOS SLM
Los SLM ejecutan IA localmente.
No dependen de Internet.
No envían datos externos.
Reducen la latencia.
Eliminan costes por consulta.
Mejoran la privacidad.
Facilitan el cumplimiento normativo.
Permiten trabajar sin conexión.
Ideal para empresas.
Ideal para desarrolladores.
Ideal para laboratorios.
Ideal para información confidencial.
☁️ Nube vs Local
Nube
Datos viajan al proveedor.
Depende de Internet.
Latencia variable.
Coste por uso.
Escalado sencillo.
Local
Datos nunca abandonan el equipo.
Sin conexión permanente.
Latencia mínima.
Coste inicial único.
Privacidad máxima.
🔐 Importante
Local no significa automáticamente seguro. La configuración sigue siendo esencial.
🖥️ REQUISITOS DE HARDWARE
⚙️ Importancia de la VRAM
Más VRAM.
Modelos mayores.
Respuestas más rápidas.
Menos intercambio con RAM.
Mayor contexto disponible.
🧠 NPUs
Cada vez más procesadores incorporan NPUs.
Reducen consumo energético.
Aceleran inferencia local.
Muy útiles en portátiles modernos.
🧰 EL STACK DE SOFTWARE LOCAL LÍDER
🦙 Ollama
Instalación sencilla.
Un comando basta.
Gestión automática.
API local integrada.
Excelente rendimiento.
🖥️ LM Studio
Interfaz gráfica intuitiva.
Sin terminal.
Descarga modelos fácilmente.
Compatible GGUF.
Excelente para principiantes.
📚 AnythingLLM
Chat privado.
RAG local.
Documentos empresariales.
Multiusuario.
Integración sencilla.
🤗 Hugging Face
Mayor repositorio mundial.
Miles de modelos.
Versionado completo.
Comunidad enorme.
Descarga directa.
⚡ Open WebUI
Interfaz moderna.
Compatible con Ollama.
Chat estilo ChatGPT.
Gestión multiusuario.
Muy configurable.
🧠 MODELOS RECOMENDADOS PARA DESPLEGAR HOY
💡 Equipos básicos
Phi-3 Mini
3.8B parámetros.
Muy rápido.
Excelente eficiencia.
Ideal para 16 GB RAM.
Gemma 2B / 7B
Liviano.
Muy preciso.
Excelente comprensión.
Buen rendimiento portátil.
🚀 Equipos medios
Mistral 7B
Excelente equilibrio.
Muy veloz.
Gran calidad.
Ideal para 32 GB RAM.
Llama 3.1 8B
Muy buena conversación.
Excelente razonamiento.
Gran ecosistema.
Perfecto para uso diario.
🔥 Equipos potentes
Llama 3.1 70B (cuantizado)
Calidad cercana a modelos comerciales.
Requiere mucha RAM o VRAM.
Ideal para servidores.
Gemma 3 (versiones mayores)
Excelente comprensión.
Muy competitivo.
Adecuado para hardware moderno.
📊 ¿Cuál elegir?
💻 16 GB RAM → Phi-3 Mini.
💻 24 GB RAM → Gemma 7B.
💻 32 GB RAM → Mistral 7B.
💻 64 GB RAM → Llama 3.1 8B.
🖥️ GPU 24 GB VRAM → Llama 3.1 70B cuantizado.
⚡ PASO A PASO: TU PRIMER CHAT 100% OFFLINE
1️⃣ Instalar Ollama
Descargar desde:
https://ollama.com
Verificar instalación:
ollama --version
2️⃣ Descargar un modelo
Ejemplo:
ollama run llama3.1:8b
Otro ejemplo:
ollama run mistral
Ver modelos instalados:
ollama list
3️⃣ Añadir una interfaz gráfica
Instalar:
Open WebUI
AnythingLLM
LM Studio
Importar:
PDFs
Word
Excel
Markdown
Código fuente
Construir un RAG completamente local.
Los documentos permanecen en el equipo.
4️⃣ Probar completamente offline
Desconectar:
Wi-Fi.
Ethernet.
VPN.
Ejecutar:
ollama run llama3.1:8b
Realizar preguntas.
La IA seguirá funcionando.
No requiere Internet.
🔒 REGLAS DE ORO DE LA SEGURIDAD LOCAL
🛡️ Regla 1
Nunca expongas el puerto local.
Restringe:
localhost.
Firewall.
VPN interna.
Evita accesos externos.
🔑 Regla 2
Actualiza modelos manualmente.
Verifica hashes.
Descarga únicamente desde fuentes oficiales.
Mantén copias verificadas.
📂 Regla 3
Aísla documentos sensibles.
Utiliza usuarios separados.
Cifra discos.
Realiza copias de seguridad.
Audita registros periódicamente.
✅ CHECKLIST DEVOPS
✅ Instalar Ollama.
✅ Descargar un modelo adecuado.
✅ Configurar Open WebUI o AnythingLLM.
✅ Importar documentos privados.
✅ Verificar funcionamiento offline.
✅ Restringir acceso al puerto local.
✅ Actualizar modelos desde fuentes confiables.
✅ Cifrar almacenamiento sensible.
🚀 CONCLUSIÓN
Los SLM representan la evolución natural de la IA privada.
Permiten ejecutar modelos potentes sin depender de terceros.
Combinan velocidad, control y confidencialidad.
Con el hardware adecuado y una configuración segura, es posible construir asistentes inteligentes completamente locales, preparados para trabajar con información sensible y sin conexión permanente a Internet.