
Guia SLM Modelos Pequenos Futuro IA
1. Qué es un SLM y por qué está ganando protagonismo Un Small Language Model (SLM) es un modelo de lenguaje diseñado para comprender y generar texto utilizando una cantidad de parámetros y recursos significativamente menor que los grandes modelos de propósito general. No existe una frontera universal….
1. Qué es un SLM y por qué está ganando protagonismo
Un Small Language Model (SLM) es un modelo de lenguaje diseñado para comprender y generar texto utilizando una cantidad de parámetros y recursos significativamente menor que los grandes modelos de propósito general. No existe una frontera universal que determine exactamente cuándo un modelo deja de ser “pequeño”, pero en la práctica el término se usa para familias compactas que pueden desplegarse con hardware mucho más accesible.
La idea central es sencilla: para muchas tareas empresariales o personales no hace falta utilizar el modelo más grande disponible. Si el trabajo consiste en clasificar consultas, resumir documentos, extraer datos, responder sobre un manual interno o ejecutar una acción repetitiva, un modelo pequeño bien elegido puede ofrecer una relación entre calidad, velocidad y costo mucho más conveniente.
El crecimiento de los SLM está relacionado con tres cambios: mejores técnicas de entrenamiento, cuantización que reduce memoria y modelos cada vez más especializados. Esto permite llevar capacidades generativas a notebooks, servidores modestos, dispositivos edge e incluso escenarios sin conexión permanente.
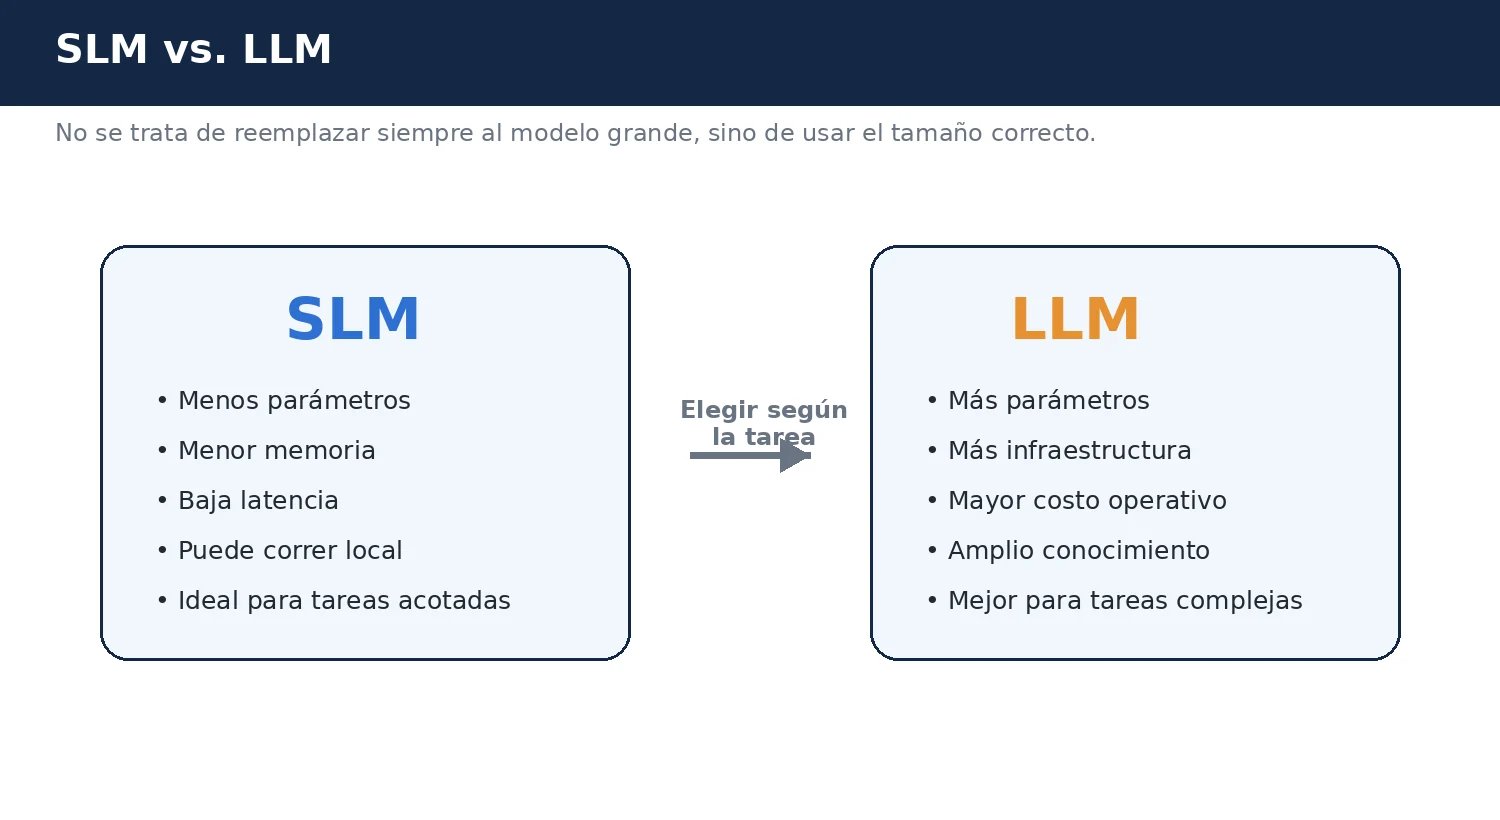
Comparación conceptual entre un SLM y un LLM.
2. SLM vs. LLM: diferencias que realmente importan
Comparar únicamente la cantidad de parámetros puede ser engañoso. Para elegir bien conviene analizar el sistema completo: memoria necesaria, velocidad de inferencia, costo por consulta, privacidad, calidad en la tarea concreta y facilidad de despliegue.
Un SLM no es automáticamente mejor por ser barato, ni un LLM es automáticamente mejor por ser grande. El criterio correcto es medir si el modelo cumple el nivel de calidad requerido para la tarea. Si dos modelos cumplen el objetivo, suele tener sentido elegir el que consuma menos recursos y sea más fácil de operar.
3. Las ventajas prácticas de los modelos pequeños
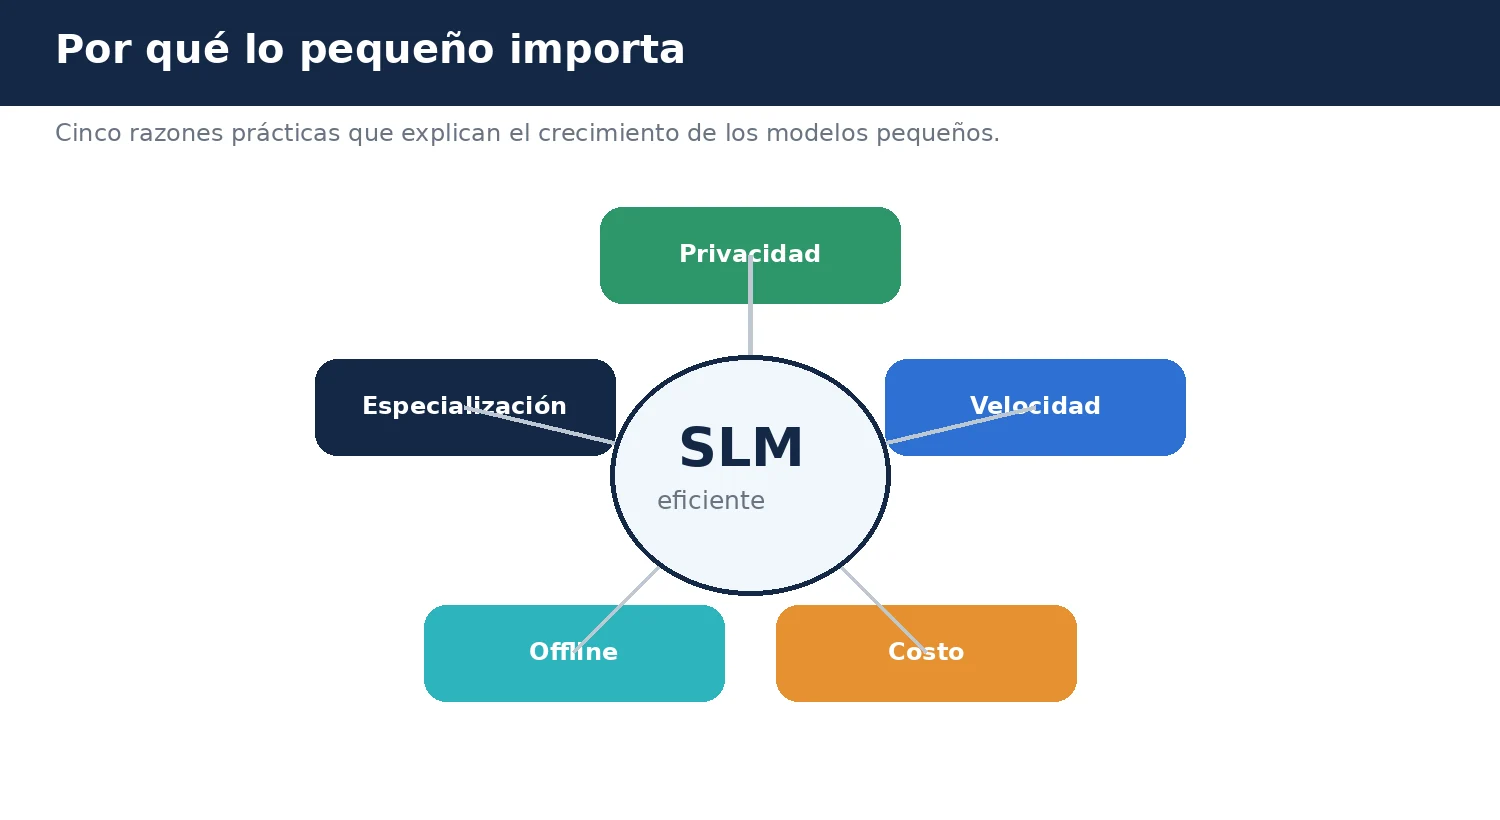
Las ventajas más frecuentes de los SLM en proyectos reales.
3.1 Menor costo
Un modelo compacto requiere menos memoria y menos capacidad de cómputo durante la inferencia. En aplicaciones con miles o millones de consultas, esta diferencia puede transformar la viabilidad económica de un producto. También reduce la necesidad de servidores con varias GPU.
3.2 Mayor velocidad y menor latencia
Al procesar menos parámetros, un SLM puede responder rápidamente, especialmente cuando se ejecuta cerca del usuario. Esto es importante en asistentes, automatizaciones, interfaces de voz y agentes que deben realizar varias llamadas al modelo durante una sola tarea.
3.3 Privacidad y control
Cuando el modelo puede ejecutarse en la propia computadora o infraestructura de la organización, los documentos y prompts pueden permanecer dentro del entorno controlado. Esto no elimina la necesidad de aplicar seguridad, permisos y auditoría, pero reduce la dependencia de enviar cada consulta a un servicio externo.
3.4 Funcionamiento offline
Un SLM local puede seguir funcionando sin Internet. Esto abre posibilidades en fábricas, vehículos, ubicaciones remotas, equipos de campo y aplicaciones donde la conectividad es irregular.
3.5 Especialización
Los modelos pequeños son especialmente interesantes cuando el dominio está bien delimitado. Con buenos prompts, RAG o ajuste fino, pueden concentrarse en un conjunto de tareas y evitar pagar por capacidades generales que el sistema nunca utilizará.
4. Limitaciones: cuándo un SLM no alcanza
Los SLM tienen menos capacidad para almacenar conocimiento general y pueden degradarse antes cuando una tarea exige razonamiento largo, múltiples dominios, instrucciones ambiguas o conocimiento muy amplio. También pueden alucinar: ser pequeños no los vuelve automáticamente confiables.
- Investigación abierta sobre muchos temas: suele favorecer a modelos grandes con mayor cobertura.
- Razonamiento complejo de varios pasos: hay que evaluar con pruebas reales y no asumir equivalencia.
- Contextos extremadamente largos: depende del modelo y del runtime; más contexto también aumenta el consumo.
- Multilingüismo: algunos modelos pequeños son excelentes en ciertos idiomas y débiles en otros.
- Uso crítico: toda salida que afecte dinero, seguridad, salud o decisiones importantes necesita validación adicional.
5. Dónde se usan los SLM en el mundo real
Los casos más atractivos comparten una característica: la tarea está relativamente bien definida. Algunos ejemplos son asistentes internos, clasificación de tickets, extracción de campos, generación de respuestas breves, resumen de documentación, ayuda contextual en software y agentes que llaman herramientas.
- Atención al cliente: detectar intención, categorizar y preparar respuestas.
- Empresas: consultar procedimientos, políticas y documentación interna.
- Desarrollo de software: autocompletado, explicación de fragmentos y tareas repetitivas.
- Edge e IoT: análisis local con conectividad limitada.
- Agentes de IA: ejecutar pasos especializados muchas veces a bajo costo.
- Aplicaciones personales: asistentes privados, búsqueda en notas y automatización local.
NVIDIA Research ha argumentado que los SLM son especialmente adecuados para muchas invocaciones dentro de sistemas de agentes, donde el modelo repite tareas especializadas y un LLM general puede resultar innecesariamente costoso.
6. Cómo elegir un SLM para tu proyecto
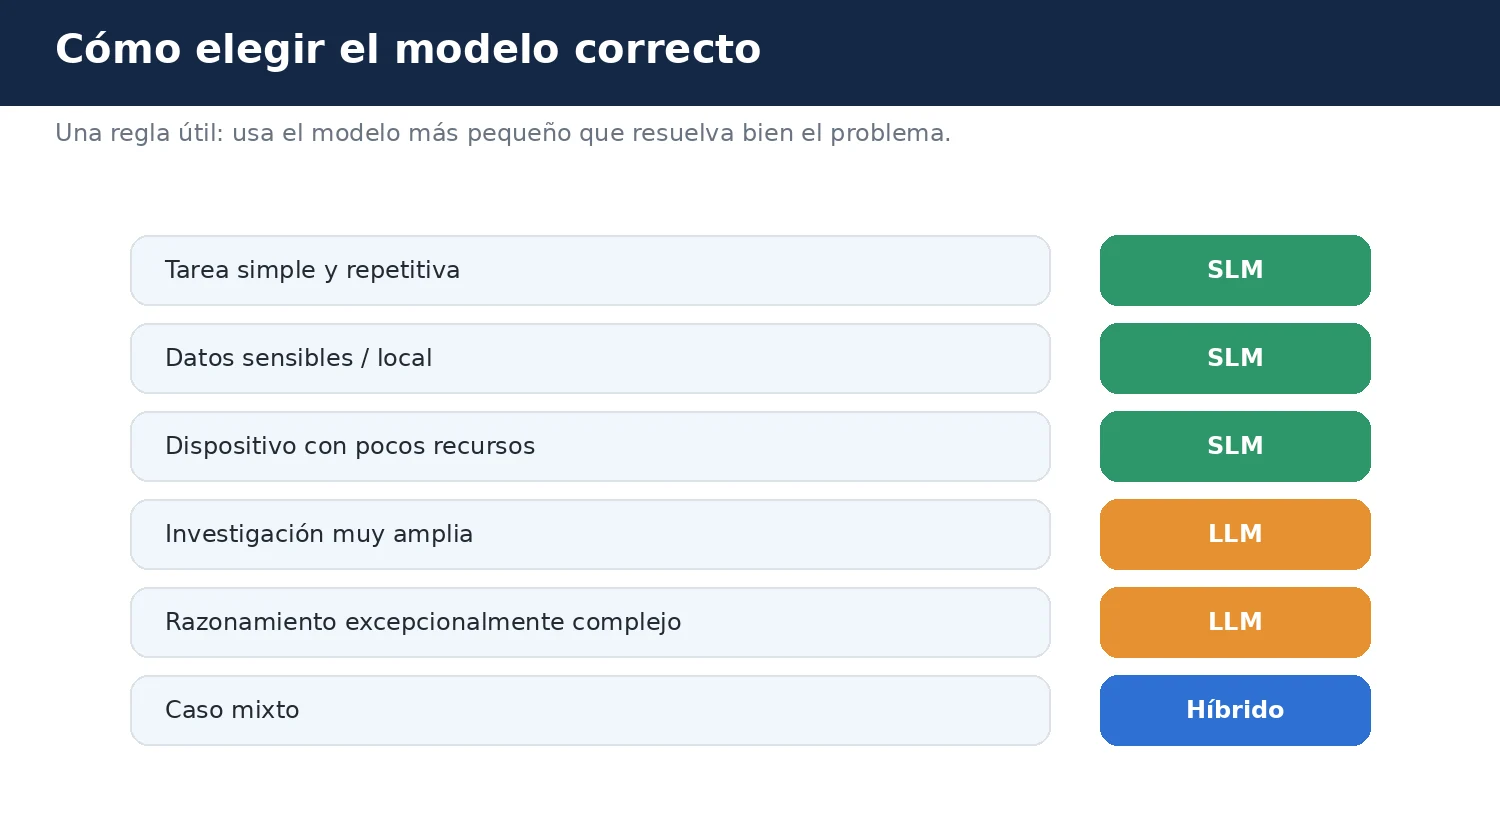
Matriz rápida para decidir entre SLM, LLM o una arquitectura híbrida.
Antes de descargar modelos, define el problema. Una selección seria comienza por el caso de uso y no por el ranking de moda.
- Define la tarea exacta: resumir, clasificar, extraer, responder, generar código, usar herramientas, etc.
- Define el idioma y el tipo de documentos.
- Establece una calidad mínima medible.
- Revisa la memoria RAM/VRAM disponible.
- Comprueba licencia y condiciones de uso.
- Evalúa tamaño cuantizado, ventana de contexto y compatibilidad con tu runtime.
- Prueba al menos dos o tres modelos con el mismo conjunto de preguntas.
Familias conocidas de modelos compactos incluyen Phi, Gemma, Granite, Qwen y Llama en variantes pequeñas. Las versiones cambian con rapidez, por lo que conviene consultar siempre la documentación oficial y probar el modelo concreto antes de adoptarlo.
7.1 Parámetros
Son valores aprendidos durante el entrenamiento. Una notación como 3B significa aproximadamente tres mil millones de parámetros. Más parámetros pueden aumentar capacidad, pero también memoria, consumo y costo.
7.2 Cuantización
La cuantización representa los pesos del modelo con menos bits. En términos prácticos, permite reducir el tamaño y ejecutar modelos en hardware más modesto. Formatos de 4 u 8 bits son comunes en inferencia local. La reducción puede introducir una pequeña pérdida de calidad, por lo que debe medirse.
7.3 Tokens
Los modelos no leen palabras exactamente como nosotros: dividen el texto en unidades llamadas tokens. Tanto el prompt como la respuesta ocupan tokens. Cuanto mayor sea el contexto, mayor será el trabajo de inferencia.
7.4 Context window
Es la cantidad máxima de tokens que el modelo puede considerar en una interacción. No significa que debas llenar siempre toda la ventana. Un contexto más pequeño y relevante suele producir sistemas más rápidos y controlables.
7.5 Inferencia
Es el momento en que el modelo ya entrenado genera una respuesta. Para un proyecto local, la mayor parte del trabajo operativo consiste en optimizar la inferencia: modelo, cuantización, memoria y velocidad.
8. Formas de ejecutar un SLM
Hay tres caminos principales. La nube administrada simplifica infraestructura; un servidor propio ofrece control; y la ejecución local maximiza independencia y privacidad. Para aprender, una herramienta de ejecución local como Ollama u otra interfaz compatible suele ser el camino más directo.
- Local en PC: ideal para aprender, prototipar y trabajar con información privada.
- Servidor on-premise: apropiado cuando varios usuarios necesitan compartir el modelo dentro de una organización.
- Nube: conveniente para escalar sin administrar hardware, aunque cambia el modelo de privacidad y costos.
- Edge: pensado para dispositivos o ubicaciones donde la respuesta debe ocurrir cerca de la fuente de datos.
9. RAG, fine-tuning y especialización
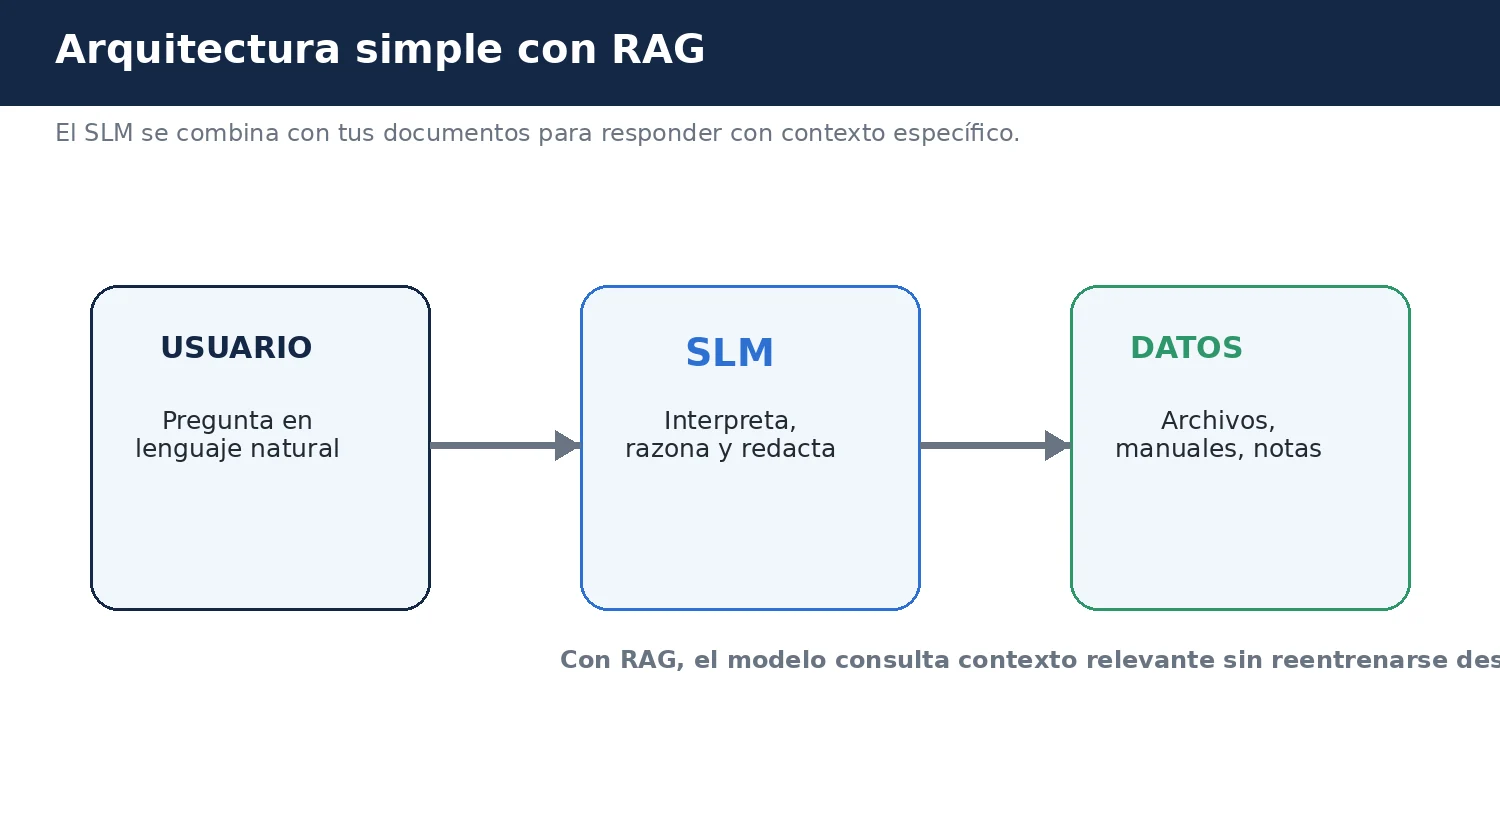
Esquema simplificado de un SLM combinado con documentos mediante RAG.
9.1 RAG
Retrieval-Augmented Generation permite buscar fragmentos relevantes en una colección de documentos y enviarlos al modelo junto con la pregunta. Es una de las mejores formas de dar conocimiento privado o actualizado a un SLM sin reentrenarlo.
9.2 Fine-tuning
El ajuste fino modifica el comportamiento del modelo mediante ejemplos. Es útil para formatos, estilo, clasificación o patrones muy específicos. No debería ser la primera solución para incorporar documentos que cambian con frecuencia; para eso, RAG suele ser más flexible.
9.3 Prompting
Un buen prompt sigue siendo fundamental. En modelos pequeños conviene ser especialmente claro: definir rol, objetivo, límites, formato de salida y qué debe hacer cuando no conoce la respuesta.
10. Proyecto práctico: asistente privado con un SLM local
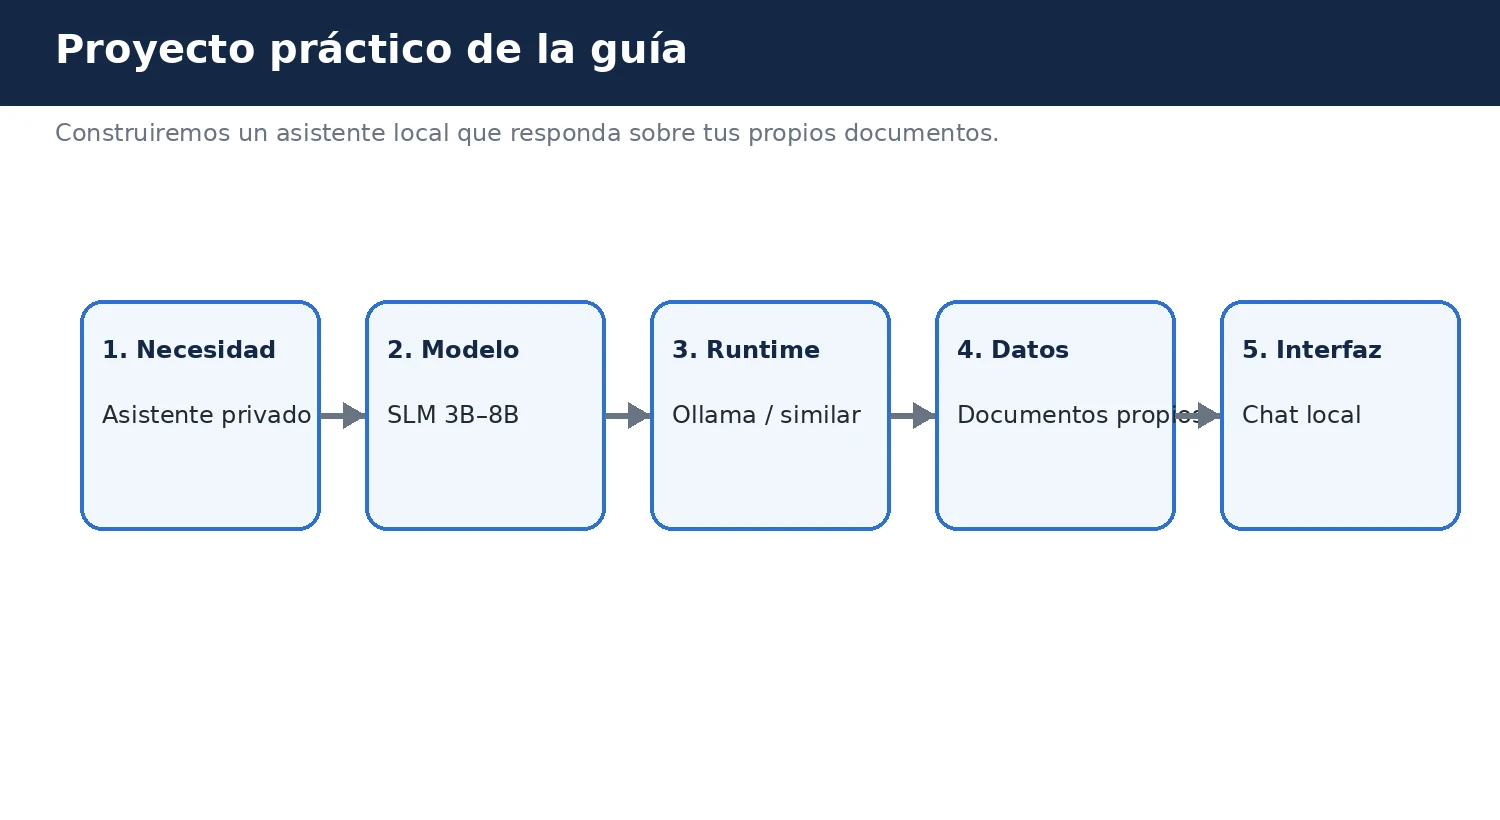
Flujo del proyecto que construiremos.
El objetivo es crear un asistente que funcione en tu computadora y responda preguntas sobre una carpeta de documentos. La implementación exacta puede variar según el sistema operativo, pero la arquitectura es siempre similar.
Paso 1 — Preparar el equipo
Comprueba la memoria disponible. Para comenzar, elige un modelo cuantizado pequeño; si tu equipo tiene recursos limitados, prioriza variantes de pocos miles de millones de parámetros. Cierra aplicaciones pesadas durante las primeras pruebas.
Paso 2 — Instalar un runtime local
Instala un runtime que pueda descargar y ejecutar modelos locales. Ollama es una opción popular por su simplicidad. También existen interfaces gráficas y runtimes alternativos. Verifica siempre los requisitos y la documentación oficial de la herramienta elegida.
Paso 3 — Elegir y probar el modelo
Descarga un modelo compacto compatible. Antes de agregar documentos, haz diez preguntas simples: instrucciones, resumen, extracción, idioma español y una tarea específica de tu proyecto. Guarda las respuestas; serán tu línea base.
Paso 4 — Preparar los documentos
Crea una carpeta con manuales, preguntas frecuentes, procedimientos o textos de ejemplo. Evita comenzar con miles de archivos. Un conjunto pequeño y limpio permite detectar errores rápidamente.
Paso 5 — Incorporar RAG
Usa una aplicación o framework que indexe los documentos, divida el contenido en fragmentos y recupere los más relevantes. El flujo será: pregunta → búsqueda semántica → fragmentos relevantes → SLM → respuesta.
Paso 6 — Definir el prompt del sistema
Ejemplo conceptual: “Responde únicamente con la información recuperada de los documentos. Si la respuesta no está presente, indica que no dispones de datos suficientes. Sé breve y cita el nombre del documento utilizado.” Esta regla reduce respuestas inventadas, aunque no las elimina por completo.
Paso 7 — Crear una batería de pruebas
Escribe entre 20 y 50 preguntas reales. Incluye preguntas fáciles, ambiguas, preguntas cuya respuesta no existe y preguntas que requieren combinar dos fragmentos. Marca manualmente qué debería responder el sistema.
Paso 8 — Ajustar
Si falla, cambia una variable por vez: modelo, prompt, tamaño de fragmentos, cantidad de fragmentos recuperados o configuración de generación. Si modificas todo a la vez, no sabrás qué produjo la mejora.
11. Cómo evaluar si el proyecto funciona bien
Una demo que parece convincente no es suficiente. La evaluación debe usar preguntas preparadas antes de ajustar el sistema.
Las metas dependen del proyecto. Lo importante es convertir “parece funcionar” en indicadores que permitan comparar modelos y configuraciones.
12. Cómo pasar de prototipo a solución real
Una solución de producción necesita más que un modelo. Debes pensar en permisos, registro de errores, actualización de documentos, respaldo, observabilidad, límites de uso y mecanismos para escalar a un modelo más potente cuando sea necesario.
- Versiona el modelo y el prompt.
- Registra latencia, errores y preguntas sin respuesta.
- Protege la carpeta o base de conocimiento.
- Agrega autenticación si hay varios usuarios.
- Define qué datos pueden entrar al sistema.
- Implementa un fallback a un LLM para casos complejos, si el negocio lo requiere.
13. Arquitecturas híbridas: SLM + LLM
Una de las estrategias más prometedoras consiste en enrutar cada consulta. El SLM atiende solicitudes frecuentes, simples o privadas; un LLM se utiliza cuando la tarea supera cierto nivel de complejidad. Así se conserva calidad sin pagar el costo máximo en todas las interacciones.
Un router puede decidir según longitud, intención, confianza, sensibilidad del dato o resultado de una primera clasificación. Este enfoque también es útil en agentes: distintas herramientas o pasos pueden usar modelos diferentes.
14. El futuro de los SLM
La tendencia apunta a modelos compactos cada vez más capaces, mejores técnicas de compresión, hardware especializado y sistemas que combinan múltiples modelos. La IA en dispositivos también aumenta el interés por ejecutar inferencia cerca del usuario.
En agentes, el argumento económico es especialmente fuerte: una sola tarea puede requerir numerosas llamadas al modelo. Si muchas de ellas son rutinarias, sustituir parte de esas llamadas por modelos especializados puede reducir costos y latencia de manera sustancial.
Por eso, “más pequeño” no significa una versión inferior de la IA. En muchos productos será una decisión de arquitectura: usar capacidad suficiente, en el lugar correcto, con el costo y la privacidad adecuados.
15. Checklist final y próximos pasos
- Elegí una tarea concreta y repetible.
- Definí una métrica mínima de calidad.
- Probé al menos dos SLM con las mismas preguntas.
- Medí RAM/VRAM, velocidad y estabilidad.
- Revisé licencia y condiciones de uso.
- Decidí si necesito RAG, fine-tuning o solo prompting.
- Preparé preguntas cuya respuesta NO está en los datos.
- Registré resultados antes de optimizar.
- Definí cuándo escalar a un LLM.
- Documenté la configuración final.
Próximo proyecto sugerido: convertir el asistente documental en un agente local que, además de responder, pueda ejecutar una acción controlada —por ejemplo, crear un borrador, clasificar un archivo o generar un reporte— manteniendo al SLM como motor principal para las tareas repetitivas.
Glosario
SLM: Small Language Model; modelo de lenguaje compacto y eficiente.
LLM: Large Language Model; modelo de lenguaje de gran escala.
Parámetro: Valor interno aprendido por el modelo durante el entrenamiento.
Token: Unidad en la que el modelo divide el texto.
Inferencia: Proceso de generar una salida con un modelo ya entrenado.
Cuantización: Reducción de precisión numérica para disminuir memoria y cómputo.
RAG: Técnica que recupera información externa y la incorpora al contexto del modelo.
Fine-tuning: Ajuste del modelo con ejemplos para modificar o especializar su comportamiento.
Edge AI: IA ejecutada cerca del dispositivo o fuente de datos.
On-premise: Infraestructura ejecutada dentro del entorno controlado de una organización.
Fuentes recomendadas
Para mantener la guía útil en un campo que cambia rápidamente, conviene consultar documentación oficial y fuentes técnicas antes de elegir versiones concretas de modelos.
- IBM Think — What are Small Language Models (SLM)? — https://www.ibm.com/think/topics/small-language-models
- IBM Think — The Power of Small — https://www.ibm.com/think/insights/power-of-small-language-models
- NVIDIA Research — Small Language Models are the Future of Agentic AI — https://research.nvidia.com/labs/lpr/slm-agents/
- Microsoft — familia Phi — https://www.microsoft.com/
- Google — familia Gemma — https://ai.google.dev/gemma
- Ollama — ejecución local de modelos — https://ollama.com/