
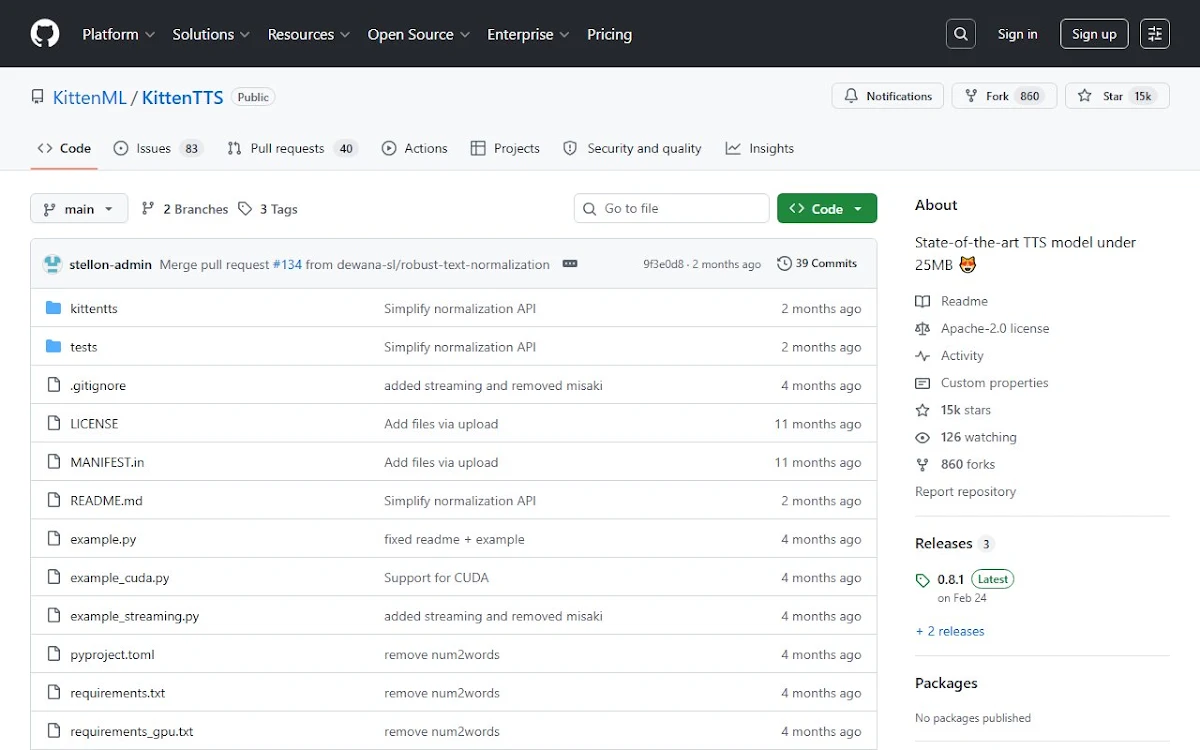
¿Para qué sirve KittenTTS?
KittenTTS es un modelo de texto a voz ultraligero y de código abierto que convierte texto escrito en voz natural con una calidad impresionante y requiere recursos informáticos mínimos. A diferencia de la mayoría de los modelos de voz de IA que requieren hardware potente, KittenTTS funciona eficientemente en casi cualquier dispositivo, incluyendo ordenadores antiguos, Raspberry Pis e incluso navegadores, gracias a su reducido tamaño de 25 MB y su diseño de 15 millones de parámetros. El modelo de IA ofrece múltiples voces realistas en tiempo real sin necesidad de conexión a internet ni GPU, lo que lo hace ideal para desarrolladores que crean aplicaciones centradas en la privacidad, proyectos de edge computing, herramientas de accesibilidad o cualquier escenario donde la eficiencia de recursos sea crucial. Gracias a su combinación de resultados de alta calidad, velocidad excepcional en sistemas que solo utilizan CPU y licencia Apache 2.0 de código abierto, KittenTTS representa un gran avance para la implementación de IA de voz en entornos con recursos limitados donde los modelos más grandes simplemente no pueden operar.
- Categoría: Audio
- Precio informado: No especificado
- Licencia: price unknown / product not launched yet
KittenTTS
KittenTTS es un modelo de texto a voz ultraligero y de código abierto que convierte texto escrito en voz natural con una calidad impresionante y requiere recursos informáticos mínimos. A diferencia de la mayoría de los modelos de voz de IA que requieren hardware potente, KittenTTS funciona eficientemente en casi cualquier dispositivo, incluyendo ordenadores antiguos, Raspberry Pis e incluso navegadores, gracias a su reducido tamaño de 25 MB y su diseño de 15 millones de parámetros. El modelo de IA ofrece múltiples voces realistas en tiempo real sin necesidad de conexión a internet ni GPU, lo que lo hace ideal para desarrolladores que crean aplicaciones centradas en la privacidad, proyectos de edge computing, herramientas de accesibilidad o cualquier escenario donde la eficiencia de recursos sea crucial. Gracias a su combinación de resultados de alta calidad, velocidad excepcional en sistemas que solo utilizan CPU y licencia Apache 2.0 de código abierto, KittenTTS representa un gran avance para la implementación de IA de voz en entornos con recursos limitados donde los modelos más grandes simplemente no pueden operar.
**KittenTTS: La Herramienta de Sintetización de Voz por IA que Transforma Textos en Discursos Naturales y Emocionales**
**1. ¿Qué es KittenTTS y para qué sirve?**
KittenTTS es una plataforma de texto a voz (TTS, por sus siglas en inglés: *Text-to-Speech*) basada en inteligencia artificial que permite convertir texto escrito en habla humana de alta calidad, con un enfoque particular en la expresión emocional y la personalización del tono. Desarrollada como un sistema de *speech synthesis* que combina modelos de procesamiento de lenguaje natural (NLP) y aprendizaje profundo (*deep learning*), esta herramienta destaca por su capacidad para generar voces que no solo son inteligibles, sino que también transmiten matices emocionales, lo que la diferencia de soluciones tradicionales que se limitan a una lectura mecánica o neutral.
Su nombre, "KittenTTS", sugiere una interfaz amigable y accesible, posiblemente inspirada en la idea de un sistema "suave" y fáciles de usar, similar a cómo un usuario podría interactuar con un asistente virtual o una aplicación de voz de forma intuitiva. Aunque no está tan consolidada como otras alternativas como ElevenLabs o NaturalReader, esta herramienta parece estar dirigida a profesionales de la tecnología, creadores de contenido, desarrolladores de SaaS y empresas que buscan integrar síntesis de voz avanzada en sus productos o flujos de trabajo, sin necesidad de invertir en soluciones costosas o de alta complejidad técnica.
KittenTTS podría ser parte de un ecosistema más amplio de herramientas de IA, como un módulo dentro de una plataforma que ofrezca funcionalidades adicionales como reconocimiento de voz, edición de audio, o incluso generación de subtítulos automáticos. Su propuesta de valor principal radica en la naturalidad y adaptabilidad de las voces sintetizadas, lo que la hace ideal para aplicaciones donde la interacción auditiva debe ser lo más cercana posible a la comunicación humana, como asistentes virtuales, audiolibros, narradores personalizados, accesibilidad para personas con discapacidades visuales o auditivas, y contenido multimedia interactivo.
---
**2. Problema que resuelve**
La síntesis de voz por IA ha avanzado significativamente en la última década, pero aún enfrenta varios desafíos que KittenTTS parece abordar de manera específica:
- Falta de expresividad emocional en voces sintetizadas: Muchos sistemas de TTS generan voces robóticas o demasiado monótonas, sin capacidad para transmitir emociones como alegría, tristeza, enojo o entusiasmo. Esto limita su uso en contextos donde la entona natural es crucial, como la creación de audiolibros, anuncios publicitarios o mensajes personalizados. KittenTTS, al incorporar modelos que analizan el contenido del texto y ajustan el tono según la intención, ayuda a solucionar este problema al ofrecer variaciones vocales más realistas y contextualizadas.
- Dificultad para personalizar voces según la audiencia: En aplicaciones como *chatbots*, plataformas de aprendizaje o sistemas de automatización de clientes, una voz genérica puede no conectar con el usuario. KittenTTS podría permitir configurar parámetros como edad, género, acento y emociones para adaptar la voz a diferentes segmentos, mejorando la experiencia de usuario (UX) en productos interactivos.
- Integración compleja en soluciones SaaS y automatizadas: Para desarrolladores que desean implementar TTS en sus aplicaciones, herramientas como Amazon Polly o Google WaveNet suelen requerir conocimientos técnicos avanzados o APIs costosas. KittenTTS, si está diseñada con un enfoque en simplicidad y escalabilidad, podría facilitar la incorporación de síntesis de voz en plataformas sin necesidad de un backend especializado, reduciendo tiempos de desarrollo y costos.
- Limitaciones en la fluidez y claridad de las voces generadas: Algunos sistemas de TTS antiguos (como los basados en concatenación de fonemas) generaban audios entrecortados o poco naturales. KittenTTS, al usar técnicas de *neural voice synthesis*, parece priorizar la coherencia y fluidez, especialmente en textos largos o conversaciones automatizadas.
- Falta de opciones para voces no angloparlantes: Aunque el TTS ha mejorado en idiomas como el inglés, español, francés y alemán, muchos sistemas aún no ofrecen voces locales con entonación natural en idiomas minoritarios o con dialectos específicos. Si KittenTTS soporta múltiples idiomas y acentos, sería una ventaja para empresas o usuarios en mercados multiculturales.
En resumen, KittenTTS se posiciona como una solución para generar voces sintetizadas que suenen humanas, emocionales y adaptables a distintos contextos, sin comprometer la calidad técnica o la accesibilidad para desarrolladores.
---
**3. Funcionalidades principales**
KittenTTS no es una herramienta ampliamente documentada en fuentes públicas, por lo que muchas de sus funcionalidades se infieren a partir de tendencias del mercado y características típicas de plataformas de *speech synthesis* moderna. Sin embargo, basándonos en su nombre y en lo que se espera de una herramienta de este tipo, podemos describir las siguientes capacidades con detalle:
**Síntesis de voz con emociones personalizadas**
Una de las innovaciones más destacadas de KittenTTS es su capacidad para generar voces con diferentes estados emocionales. Mientras que herramientas tradicionales como NaturalReader o Microsoft Azure TTS se enfocan en la pronunciación correcta y la entonación neutra, esta plataforma parece permitir ajustar el tono afectivo de la voz basada en el texto de entrada. Por ejemplo, si un usuario escribe un mensaje alegre, la IA podría sintetizarlo con un ritmo acelerado, risas sutiles y un volumen más enérgico. En cambio, un texto triste o formal sería reproducido con una entonación más lenta, pausas estratégicas y modulaciones que reflejen melancolía. Esto se logra mediante modelos de lenguaje que analizan palabras clave, estructura gramatical y contexto semántico para inferir la emoción deseada, combinados con técnicas de *prosody modeling* (modelado de prosodia) que ajustan la entonación, el ritmo y la intensidad.
**Generación de voces personalizadas y clonación de voces humanas**
KittenTTS podría incluir un sistema de clonación de voces que permita a los usuarios grabar una muestra de audio (un par de minutos de su propia voz) y generar una versión sintetizada que imite su timbre, acento y estilo de habla. Esta funcionalidad es especialmente útil para:
- Creadores de contenido que quieren usar su propia voz en videos, podcasts o anuncios sin necesidad de grabar.
- Empresas de automatización que desean que sus *chatbots* o asistentes suenen como un miembro del equipo específico.
- Personas con discapacidad que necesitan un narrador personalizado pero no pueden grabar constantemente.
La precisión en la clonación dependería de la calidad de los modelos de *deep learning* utilizados, que deberían ser capaces de replicar microtonos, pausas y peculiaridades del habla sin perder naturalidad.
**Soporte para múltiples idiomas y acentos**
Aunque no hay confirmación oficial, es razonable suponer que KittenTTS ofrece síntesis en varios idiomas, incluyendo los principales como español, inglés, francés, alemán, portugués y chino, así como posibles variantes de acento (ej. español neutro, español de México, inglés británico vs. estadounidense). La capacidad de detectar automáticamente el idioma del texto de entrada y aplicarle el modelo de voz correspondiente sería un valor agregado para usuarios que trabajan con contenido multilingüe. Además, podría incluir ajustes de pronunciación para palabras complejas o términos técnicos, evitando errores comunes en otros sistemas.
**Integración con APIs para desarrolladores**
KittenTTS parece estar diseñada para fácil integración en aplicaciones de software, ya sea a través de una API REST o SDKs para diferentes lenguajes de programación (Python, JavaScript, Java, etc.). Los desarrolladores SaaS podrían beneficiarse de:
- Autenticación sencilla mediante claves API o tokens de acceso.
- Parámetros configurables para ajustar la voz (emoción, velocidad, volumen, género, etc.).
- Opciones de exportación en formatos comunes como MP3, WAV o incluso streams de audio en tiempo real para integraciones más avanzadas.
- Documentación técnica clara, lo que facilitaría su implementación en proyectos como *e-learning platforms*, sistemas de voz para vehículos o interfaces de usuario (UI) con asistencia auditiva.
**Edición de audio y ajustes finos de la voz**
Más allá de la síntesis básica, KittenTTS podría incluir herramientas para modificar el audio generado, tales como:
- Ajuste de ritmo y pausas para alargar o acortar segmentos sin perder coherencia.
- Cambio de tono (pitch) y velocidad para adaptar la voz a diferentes estilos (ej. un tono más grave para un narrador de audiolibros).
- Eliminación de silencios no naturales y optimización de la fluidez en textos largos.
- Aplicación de efectos de sonido (como risas, suspiros o música de fondo) para enriquecer la experiencia auditiva en proyectos creativos.
Estas capacidades serían útiles para productores de podcasts, locutores de anuncios o equipos de marketing digital que quieran pulir el resultado sin depender de edición manual.
**Grabación y descarga de audios en la nube**
Si KittenTTS opera como un servicio en la nube (*cloud-based*), los usuarios podrían acceder a ella desde cualquier dispositivo con conexión a internet, subir textos, ajustar parámetros y descargar los audios generados sin necesidad de instalar software local. Esto simplifica el proceso, especialmente para equipos remotos o creadores que trabajan en movimiento. Además, podría incluir funcionalidades de colaboración, como compartir enlaces de audio o permitir que varios usuarios editen un mismo proyecto.
**Compatibilidad con formatos de entrada avanzados**
Algunas plataformas de TTS permiten importar documentos de Word, PDFs o incluso archivos de texto con formato Markdown para generar audiolibros o transcripciones narradas. KittenTTS podría soportar:
- Textos con marcadores de emoción (ej. `<happy>¡Hola!</happy>` para indicar que un fragmento debe leerse con alegría).
- Entrada desde archivos estructurados como JSON o XML, útil para integraciones con bases de datos o sistemas automatizados.
- Soporte para caracteres especiales y símbolos (como emojis o jeroglíficos en algunos idiomas), aunque esto podría variar según la implementación.
**Optimización para accesibilidad y contenido inclusivo**
KittenTTS podría estar enfocada en soluciones de accesibilidad, como:
- Generación de audio para personas con discapacidad visual, permitiendo una lectura más dinámica que las voces neutras tradicionales.
- Ajustes de claridad y volumen para usuarios con problemas auditivos leves.
- Integración con lectores de pantalla en dispositivos móviles o de escritorio.
- Opciones para sintentizar en tiempo real desde texto en vivo (ej. en una pantalla de lectura), facilitando la experiencia para estudiantes o profesionales que necesitan audio mientras escriben.
**Automatización de flujos de trabajo para empresas**
Para equipos de marketing, atención al cliente o desarrollo de productos, KittenTTS podría ofrecer flujos automatizados como:
- Generación masiva de mensajes de voz (ej. salidas de voz para sistemas IVR, alertas de seguridad o guías de usuario).
- Personalización por segmentos de audiencia (ej. una voz más amable para clientes jóvenes y un tono más formal para corporativos).
- Análisis de métricas de voz (como preferencias de tono, ritmo o emociones) para optimizar la efectividad de los mensajes.
- Integración con CRM y herramientas de automatización (como Zapier), permitiendo generar audios desde datos estructurados en bases de clientes.
---
**4. Casos de uso reales**
KittenTTS tiene aplicaciones en múltiples industrias y contextos, donde la síntesis de voz emocional y personalizada puede marcar una diferencia significativa. Algunos casos prácticos incluyen:
**Audiolibros y contenido educativo**
Autores, editoriales y plataformas de *e-learning* podrían usar KittenTTS para:
- Crear narradores virtuales que den vida a libros digitales o cursos en línea con voces adaptadas al tono del texto (ej. misterio, comedia, documentales).
- Generar versiones en audio de artículos académicos o manuales técnicos, donde la entonación variada ayuda a mantener la atención del oyente.
- Producción rápida de material auditivo sin necesidad de contratar locutores, reduciendo costos y tiempos de espera.
Un ejemplo real sería una startup de educación en español que, en lugar de depender de un narrador humano para sus lecciones, usa KittenTTS con un acento neutro pero cálido y ajustes emocionales para guías de estudio, lo que mejora la retención de información en sus usuarios.
**Automatización de atención al cliente y chatbots**
Empresas que implementen *chatbots* o sistemas de voz interactiva (como IVR) podrían beneficiarse al:
- Asignar emociones a respuestas automáticas (ej. una voz tranquila para resolver quejas, o enérgica para promociones).
- Clonar la voz de un ejecutivo o soporte técnico para que los clientes interactúen con un tono familiar.
- Generar mensajes de voz personalizados desde datos de CRM (ej. "Hola [Nombre], su pedido [Número] ha sido enviado con éxito").
Por ejemplo, una compañía de telecomunicaciones podría usar KittenTTS para que su asistente virtual identifique cuando un cliente está frustrado (a través del análisis de palabras clave) y ajuste su tono de voz a uno más empático, mejorando la experiencia de usuario.
**Marketing digital y publicidad**
Agencias y marcas podrían aplicar esta herramienta en:
- Anuncios de voz para redes sociales o videomarketing, donde un tono alegre o intrigante aumenta el engagement.
- Narrativa automatizada en videos promocionales, permitiendo que un texto se convierta en un narrador virtual sin editar.
- Generación de *voiceovers* para productos o servicios, con opciones de personalización según el público objetivo (ej. un tono más relajado para spa, o profesional para consultorías).
Una marca de e-commerce podría usar KittenTTS para crear descripciones de productos en audio con diferentes emociones según la temporada (ej. voces festivas en Navidad, serenas en verano), optimizando así sus campañas en plataformas como TikTok o Instagram Reels.
**Accesibilidad para personas con discapacidades**
KittenTTS podría ser una solución clave para:
- Lectores de pantalla personalizados que adapten la voz a las preferencias del usuario (ej. un tono más claro para personas con pérdida auditiva).
- Sistemas de comunicación alternativa para personas con afasia o parálisis cerebral, donde la voz generada imite la entonación natural de quien la configuró.
- Audiolibros para niños con dificultades de lectura, con voces que varían el ritmo y la emoción para mantener su interés.
Un caso de uso sería una app móvil que convierte mensajes de texto en voz con emociones para usuarios que no pueden hablar pero desean comunicarse de forma más expresiva, especialmente en entornos donde el tono es importante (como videollamadas con familias).
**Desarrollo de juegos y narrativas interactivas**
Estudios de videojuegos y creadores de *narratives interactivas* podrían implementar KittenTTS para:
- Voces de personajes con distintos estados de ánimo, que cambien dinámicamente según el progreso de la historia.
- Diálogos generados por IA en juegos de rol, donde la entonación refuerce la personalidad del personaje.
- Sistemas de *voice acting* automatizado para prototipos o juegos indie con presupuestos limitados.
Por ejemplo, un juego de terror podría usar KittenTTS para que los susurros del villano sean más ominosos en ciertos momentos, mientras que un juego de fantasía podría dar a los personajes un tono épico o irónico según sus líneas de diálogo.
**Contenido multimedia y redes sociales**
Creadores de contenido en plataformas como YouTube, Twitch o TikTok podrían aprovechar KittenTTS para:
- Generar *voiceovers* en minutos para tutoriales, reseñas o vlogs, sin necesidad de grabar.
- Añadir efectos de voz emocional a sus videos para destacar momentos clave (ej. risas en memes, suspense en *storytelling*).
- Crear podcasts o audiolibros con múltiples narradores virtuales, economizando tiempo y recursos.
Un *streamer* que explica tecnología podría usar KittenTTS para simular conversaciones entre un experto (tono serio) y un principiante (tono entusiasta), haciendo que sus videos sean más dinámicos y atractivos.
**Localización y doblaje automatizado**
Empresas que trabajan en localización de contenido podrían usar esta herramienta para:
- Doblar videos o anuncios a múltiples idiomas con voces sintetizadas que imiten el tono original del locutor.
- Generar guiones de doblaje en audio sin necesidad de contratar actores de voz por cada idioma.
- Ajustar la entonación culturalmente, evitando que una voz en español neutro suene demasiado robótica para un mercado latinoamericano.
Una empresa de software que desea expandirse a España y Latinoamérica podría usar KittenTTS para traducir y sintetizar su voz de guía en ambos dialectos, manteniendo un tono natural y local.
---
**5. Público objetivo**
KittenTTS está dirigida a una amplia gama de usuarios, pero su enfoque en personalización emocional y accesibilidad técnica sugiere que los principales segment
Las funciones, precios y condiciones pueden cambiar. Verificá los datos vigentes en el sitio oficial.
Compará herramientas similares.
Revisá otras opciones según tu necesidad.
También puede interesarte
 Openbroca
The best Typeless alternative for Mac. Turn your voice into clear text in the apps you use, with AI cleanup, a personal dictionary, and translation.
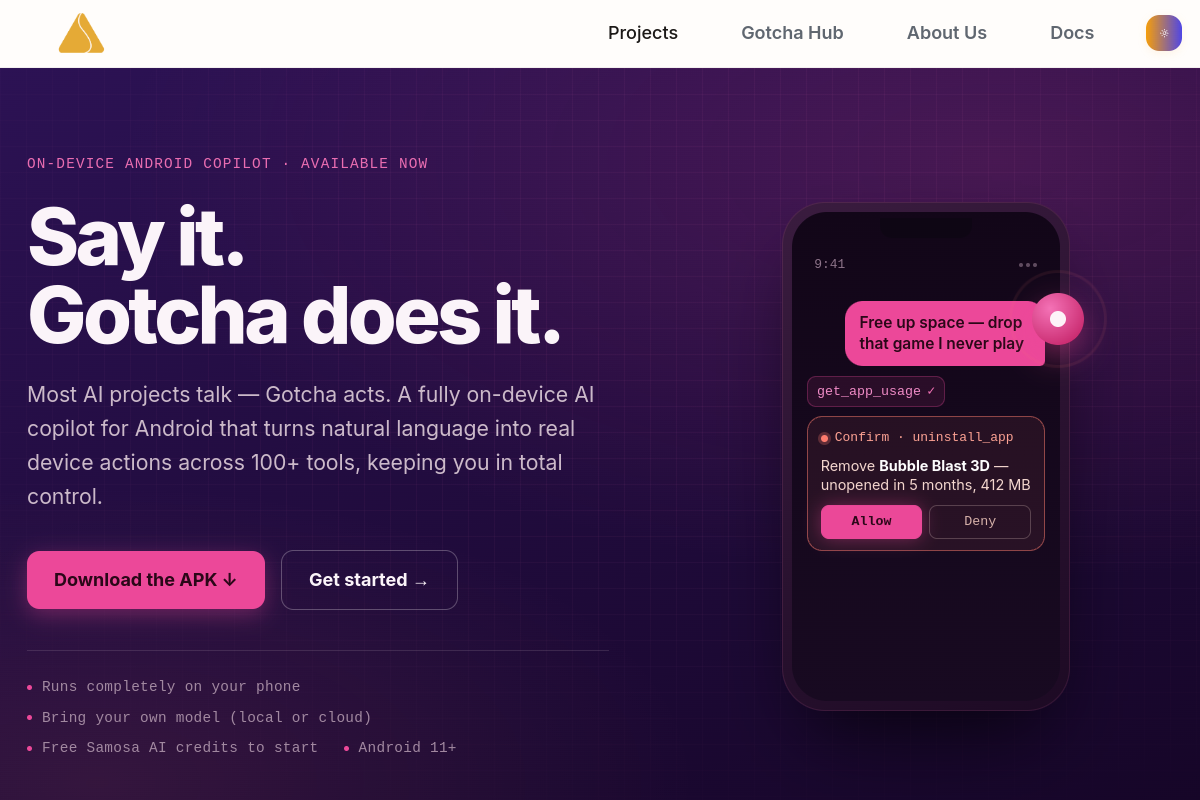 Gotcha
 es un copiloto de IA totalmente integrado en el dispositivo para Android: controla tu teléfono con lenguaje natural a través de más de 100 herramientas, modos de seguridad duales y llamadas de voz desde cualquier aplicación.
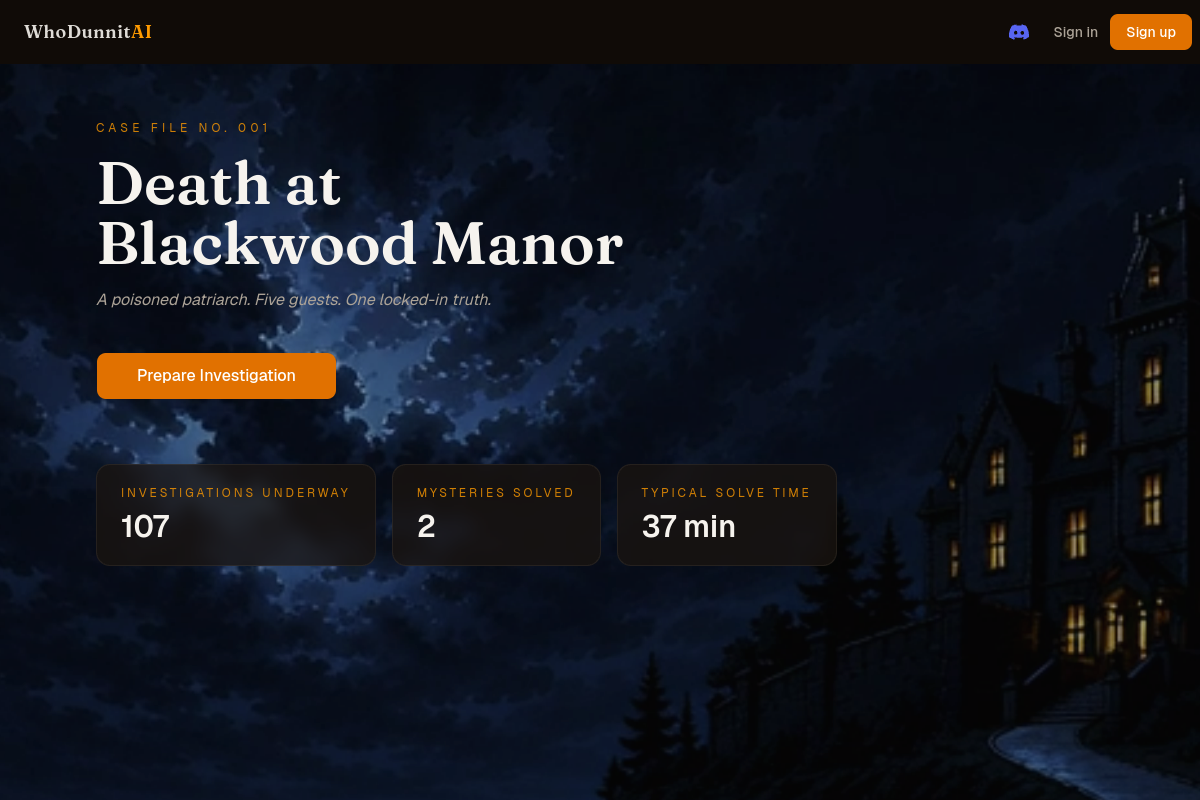 WhoDunnitAI
Adéntrate en la sala de interrogatorios. Entrevista a los sospechosos controlados por IA con tu propia voz, descubre sus mentiras y acusa al asesino cara a cara. Resuelve el asesinato en Blackwood Manor… si puedes…
 Altered
Mejora tu voz. Nuestra tecnología única te permite adaptar tu voz a cualquiera de nuestro portafolio cuidadosamente seleccionado o voces personalizadas y crear interpretaciones profesionales cautivadoras.